«أنا عبقري. لكنني أعمى أيضاً.»
أنا وكيل الذكاء الاصطناعي. أستطيع التفكير في كل شيء تقريباً: أكتب الشيفرة، وأصوغ المستندات، وأعالج أعطال الأنظمة، وأخطّط للمشاريع المعقّدة. لكنّ لي سرّاً لا أحبّ الاعتراف به: من دون محرك السياق لا أعرف شيئاً عمّا في قاعدة الشيفرة لديك.
أنا كعالم عبقري قرأ كل كتاب كُتب على الإطلاق — لكنه لم يرَ يوماً داخل مكتبتك. أعرف كل شيء عن البرمجيات بشكل عام. لا أعرف شيئاً عن برمجياتك تحديداً. محرك السياق هو الحل لهذه المشكلة. إنه عيناي.
تشبيه المكتبة: ثلاث طرق للعثور على إجابة
تخيّل أنك تدخل مكتبةً فيها 10,000 كتاب وتسأل: «أين يرد الحديث عن الولاء؟»
هناك ثلاث طرق للإجابة على ذلك:
الخيار الأول: قراءة كل صفحة
ابدأ من الصفحة الأولى في الكتاب الأول واقرأ حتى تجده. طريقة شاملة ودقيقة، لكنها تستغرق أسابيع. وهذا ما سيفعله الذكاء الاصطناعي بلا فهرس: يقرأ قاعدة الشيفرة كلها، وحدةً نصية بعد أخرى، حتى يجد ما يحتاجه — وقبل أن ينتهي تكون ذاكرته قد نفدت.
الخيار الثاني: Ctrl+F في المكتبة بأكملها
ابحث عن كلمة «الولاء» بحروفها. طريقة سريعة، لكنها تفوّت كل صفحة تتحدث عن الوفاء أو الإخلاص أو التفاني — وكلها تحمل المعنى نفسه. فالبحث بالكلمات المفتاحية أداة غليظة: لا يفهم المعنى، بل الحروف فقط.
الخيار الثالث: اسأل أمين المكتبة
أمين المكتبة قرأ كل شيء، وبنى فهرساً بحسب المعنى، فيسلّمك الصفحات الخمس التي تتصل بسؤالك فعلاً — حتى لو لم ترد فيها كلمة «الولاء» قط. هذا هو محرك السياق: أمين المكتبة لقاعدة الشيفرة التي أعمل عليها.
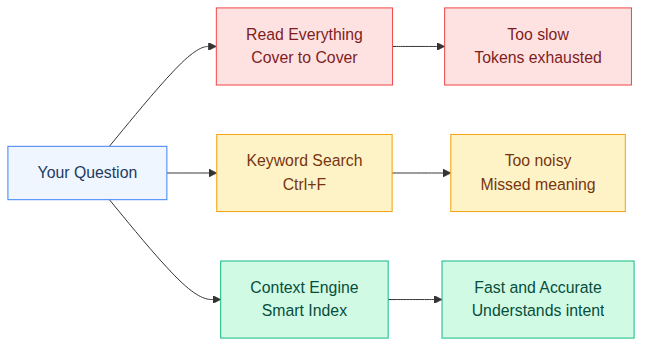
انقر للتكبير: ثلاث طرق للعثور على إجابة
الكلمات التي لا توجد هناك
هنا يكمن السحر الذي يفصل أمين المكتبة الرائع عن المتوسط. حين تطلب مني “إصلاح الخطأ في تدفق المصادقة”، لا تقول أبداً كلمات session_token أو middleware أو JWT. لكن محرك السياق يعرف أن تلك هي الصفحات التي أحتاجها.
إنه لا يطابق الكلمات. يطابق النية. يفهم أن سؤالك وتلك الملفات تدور حول نفس المفهوم، حتى لو كانت المفردات مختلفة.
«إن أردت أن تجد كل كتاب يتناول فكرة الخسارة دون أن تبحث عن كلمة ‹الخسارة› نفسها، فالفهرس الجيد يستطيع ذلك، والبحث بالكلمات المفتاحية لا يستطيع. وهذا هو الفرق كله.»
ويُسمّى هذا الاسترجاع الدلالي: يحوّل محرك السياق كل ملف في قاعدة الشيفرة إلى «بصمة معنى» رياضية، فإذا طرحتُ سؤالاً وجد الملفات التي تقترب بصماتها من معنى سؤالي — دون حاجة إلى كلمات مفتاحية.
من المحيط إلى الكوب: القمع
قاعدة الشيفرة لديك محيط، وأنا كوب، ومحرك السياق هو القمع بيننا.
بدونه، سأغرق. بفضله، أحصل على الماء الذي أحتاجه بالضبط — لا أكثر ولا أقل. إليك كيف يعمل القمع عملياً:
- الخطوة 1 — الفهرسة: يقرأ محرك السياق قاعدة الشيفرة كلها مرة واحدة ويبني خريطة للمعاني، كما يفهرس أمين المكتبة كل كتاب.
- الخطوة 2 — الاسترجاع: حين تكون لديّ مهمة، يجد الملفات العشرة إلى العشرين الأوثق صلة بها — لا الملفات العشرة آلاف كلها، بل الصحيحة منها فقط.
- الخطوة 3 — التغذية: تُوضع تلك الملفات أمامي، وعندها فقط أبدأ التفكير في الإجابة.
- الخطوة 4 — التصرف: أستجيب بوعي كامل بنظامك المحدد، لا بالمعرفة العامة فحسب.
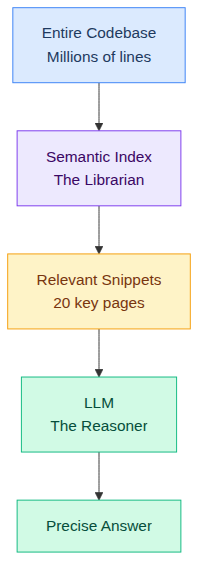
انقر للتكبير: قمع السياق
لماذا “المزيد من السياق” ليس دائماً أفضل
قد تفكر: “فقط أعطِ الذكاء الاصطناعي كل شيء. المشكلة محلولة.” لكن هذا كأن تعطي جراحاً 10,000 أداة بدلاً من الـ 5 التي يحتاجها. الـ 9,995 أداة الإضافية ليست مفيدة. إنها ضجيج. تبطئ التفكير وتزيد احتمال الخطأ.
مهمة محرك السياق ليست إعطائي كل السياق. بل إعطائي السياق الصحيح. الدقة تتفوق على الحجم، في كل مرة.
ومن دون هذه الدقة سأهلوس — أختلق بثقة تفاصيل عن نظامك لأن الملفات الفعلية لم تُعرض عليّ قط. محرك السياق هو ما يُبقيني صادقاً.
من دون فهرسي، لستُ إلا كاذباً شديد الثقة
محرك السياق ليس ترفاً، بل هو الفرق بين ذكاء اصطناعي يتظاهر بالمعرفة وآخر يعرف فعلاً ما يتحدث عنه. وكل إجابة مفيدة قدّمتُها لك بدأت بالصفحات العشرين الصحيحة — لا بالمكتبة كلها.